Phantom squatting: gdy AI podsuwa fałszywe domeny
Wyjaśniamy phantom squatting: atak, w którym oszust rejestruje domenę zmyśloną przez AI i używa jej do phishingu, malware lub przejęcia danych.
TL;DR
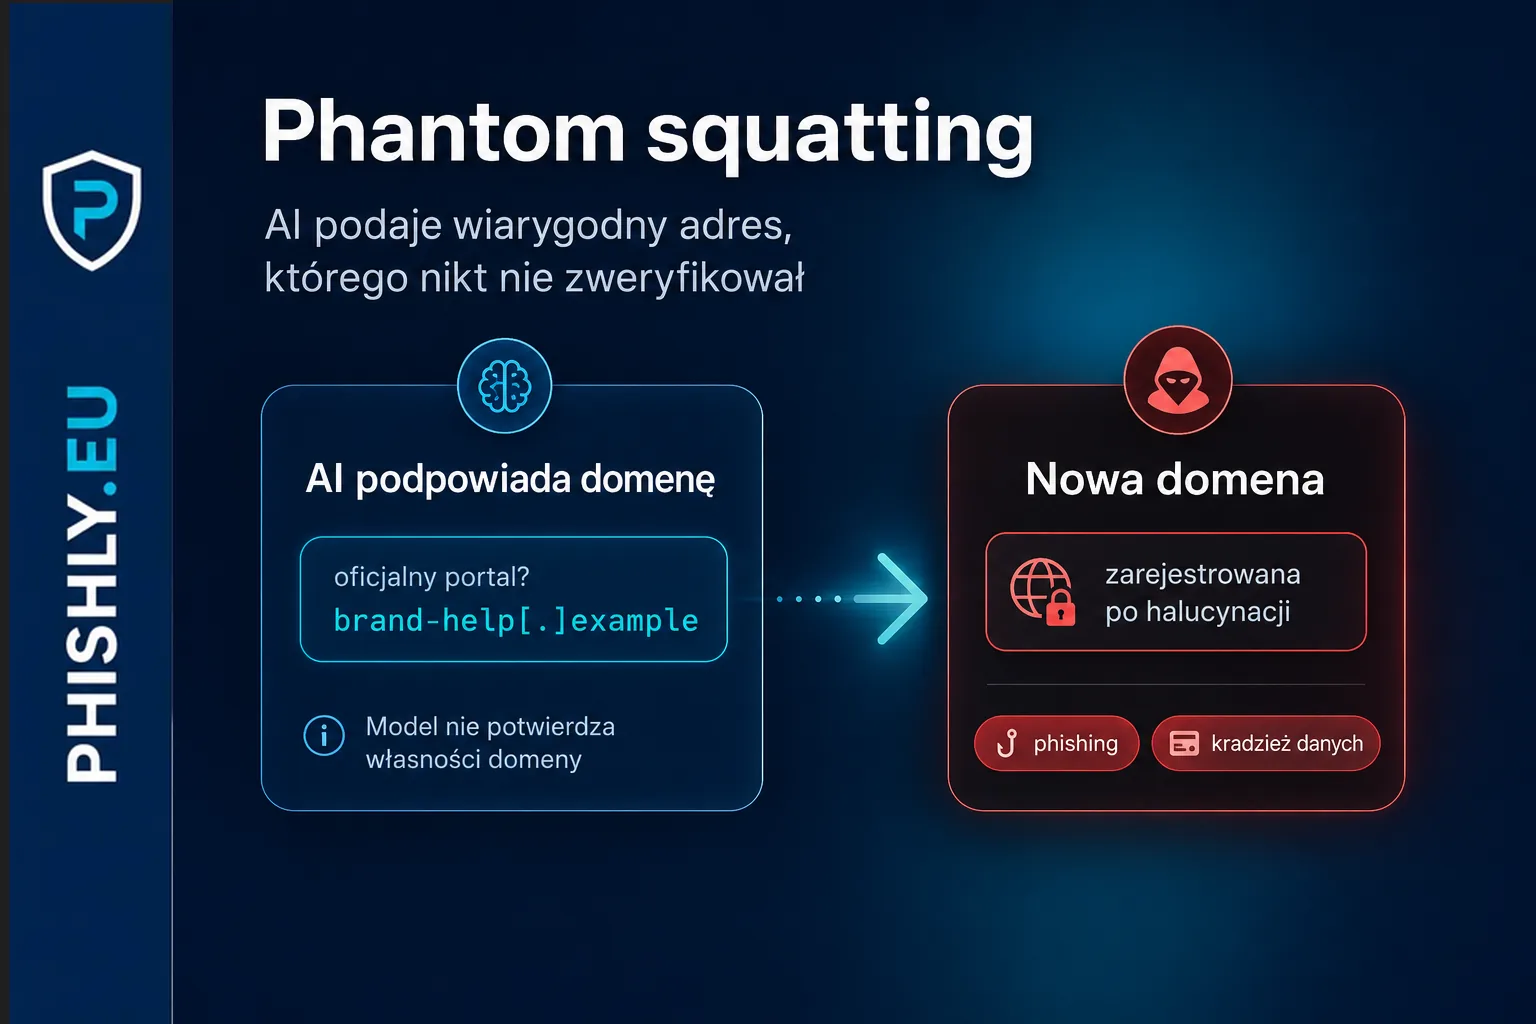
Phantom squatting to nadużycie halucynacji modeli AI. Model językowy może podać adres strony, który wygląda wiarygodnie, ale w rzeczywistości nie istnieje. Atakujący może taki adres zarejestrować i przygotować pod nim phishing, fałszywą aplikację, malware albo stronę przechwytującą dane.
To nie jest tylko problem techniczny po stronie modelu. Ryzyko pojawia się wtedy, gdy człowiek, deweloper albo agent AI traktuje wygenerowany link jak pewne źródło. W tym scenariuszu zaufanie przenosi się z oficjalnej domeny na odpowiedź narzędzia AI.
Dla firm korzystających z AI oznacza to nowy punkt kontrolny: link, domena, endpoint API albo nazwa portalu podana przez asystenta nie powinny trafiać do przeglądarki, kodu, dokumentacji ani automatycznego procesu bez sprawdzenia w niezależnym źródle.
Czym jest phantom squatting
Phantom squatting to technika, w której atakujący rejestruje domenę wymyśloną wcześniej przez duży model językowy. Duży model językowy, czyli LLM od angielskiego large language model, potrafi generować odpowiedzi, które brzmią pewnie i logicznie, ale nie zawsze są zgodne z faktami.
W klasycznym phishingu użytkownik dostaje e-mail, SMS, wiadomość w komunikatorze albo reklamę prowadzącą do fałszywej strony. W phantom squattingu przynęta może pojawić się wcześniej, w odpowiedzi AI. Użytkownik pyta o portal logowania, dokumentację, stronę pomocy, aplikację mobilną albo endpoint integracyjny. Model podaje adres, który pasuje językowo do marki i kontekstu, ale nie jest oficjalną domeną.
Jeżeli ta domena jest wolna, atakujący może ją zarejestrować. Wtedy link przestaje być tylko błędem modelu. Staje się miejscem, które może zbierać hasła, kody, dane kart, pliki, tokeny, informacje biznesowe albo ruch generowany przez automatyczne narzędzia.
W szerszym sensie to kolejny wariant problemu opisanego wcześniej przy ChatGPhish i złośliwych linkach w podsumowaniach AI. Różnica jest ważna. W ChatGPhish treść kontrolowana przez atakującego może trafić do odpowiedzi AI. W phantom squattingu model może sam zaproponować domenę, której nikt jeszcze nie posiada.
Dlaczego taki atak działa
Phantom squatting działa, bo zmienia źródło zaufania. Użytkownik nie dostaje wiadomości od nieznanego nadawcy. Dostaje odpowiedź od narzędzia, z którego korzysta w pracy. To może być asystent do researchu, narzędzie w przeglądarce, asystent kodowania, firmowy chatbot albo agent AI wykonujący kilka kroków procesu.
Model nie musi mieć złej intencji. Wystarczy, że uzupełni wzorzec. Jeżeli marka ma kilka usług, portale logowania, dokumentację, aplikację mobilną i typowe nazwy subdomen, model może stworzyć adres, który wygląda naturalnie. Dla człowieka taki link bywa bardziej przekonujący niż przypadkowy ciąg znaków.
Drugi powód to reputacja domeny. Nowo zarejestrowana domena często nie ma historii. Nie występowała wcześniej w kampanii phishingowej, nie ma wpisów na listach blokad i może jeszcze nie mieć jednoznacznej klasyfikacji w narzędziach bezpieczeństwa. To nie oznacza, że jest bezpieczna. Oznacza tylko, że systemy reputacyjne mogą nie mieć wystarczającego sygnału.
Trzeci element to automatyzacja. Jeżeli agent AI sam otwiera adresy, pobiera dokumentację, przetwarza treść strony albo używa linku jako elementu konfiguracji, czas na reakcję człowieka znika. W zwykłym phishingu ktoś musi kliknąć, przepisać dane albo uruchomić plik. W procesie agentowym część decyzji może wydarzyć się bez tego momentu zatrzymania.
Jak wygląda cykl phantom squattingu
W raporcie Unit 42 mechanizm został opisany jako proces obejmujący rozpoznanie wzorców halucynacji, rejestrację domeny, użycie AI jako kanału dostarczenia linku i ominięcie części filtrów reputacyjnych. Dla użytkownika firmowego ten proces można uprościć do pięciu kroków.
Najpierw człowiek albo agent pyta AI o adres usługi. Potem model podaje wiarygodnie brzmiącą domenę. Jeżeli domena nie istnieje, atakujący może ją zarejestrować. Następnie pod adresem pojawia się fałszywa strona, aplikacja, dokumentacja albo punkt zbierający dane. Ostatni krok to decyzja: użytkownik albo proces automatyczny traktuje link jak prawdziwy, albo zatrzymuje się i sprawdza źródło.
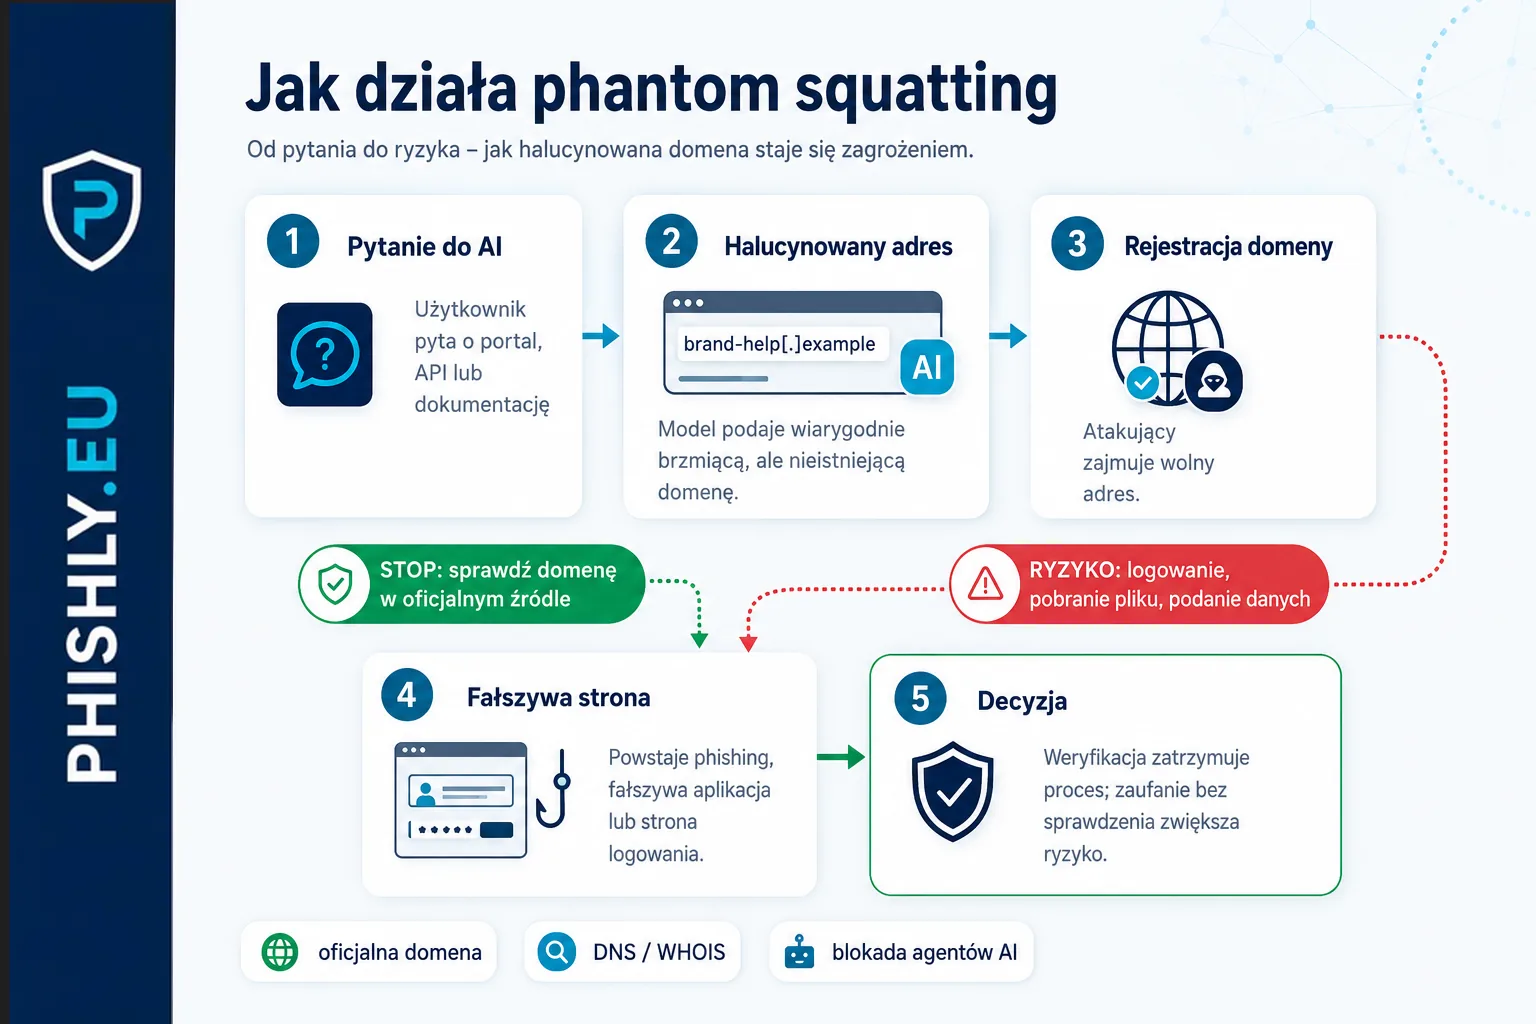
Schemat pokazuje, że problemem nie jest samo wygenerowanie linku przez AI, ale moment, w którym człowiek albo agent traktuje ten link jak zweryfikowane źródło.
Unit 42 opisał przypadki, w których domeny przewidziane jako halucynowane zostały później zarejestrowane przez atakujących. W jednym scenariuszu chodziło o domenę podszywającą się pod marketplace usługi pocztowej. Po rejestracji pojawił się zestaw phishingowy wyłudzający dane płatnicze i identyfikacyjne. W innym scenariuszu fałszywa domena podszywająca się pod usługę pocztową prowadziła do pobrania aplikacji Android poza oficjalnym sklepem.
Nie trzeba przenosić tych przykładów jeden do jednego na polski rynek, żeby zrozumieć mechanizm. Podobny wzorzec może dotyczyć fałszywego portalu kurierskiego, domeny udającej panel bankowy dla firm, strony wsparcia SaaS, portalu HR, dokumentacji API albo aplikacji używanej przez klientów.
Gdzie pojawia się ryzyko w firmie
Najbardziej oczywisty wariant dotyczy pracownika, który pyta AI o stronę logowania albo portal obsługi. Jeżeli model poda zmyślony adres, pracownik może kliknąć i wpisać dane. To nadal mieści się w szerszym obszarze, który opisujemy w poradniku co to jest phishing, ale z innym początkiem ataku.
Drugi wariant dotyczy zespołów technicznych. Deweloper może poprosić asystenta kodowania o dokumentację biblioteki, adres webhooka, endpoint API, panel integracyjny albo przykład konfiguracji. Jeżeli taki adres trafi do kodu, dokumentacji wewnętrznej albo pipeline’u, błąd może zostać utrwalony i powielony przez kolejne osoby.
Trzeci wariant dotyczy autonomicznych agentów AI. Agent może dostać zadanie: znajdź dokumentację, pobierz schemat API, porównaj konfigurację, otwórz link, streść stronę, przygotuj integrację. Jeżeli agent sam korzysta z adresów wygenerowanych przez model, organizacja potrzebuje kontroli technicznej, a nie tylko przypomnienia dla użytkownika.
Dlatego temat jest szczególnie ważny dla firm technologicznych, zespołów IT i dostawców usług cyfrowych. W branżach takich jak software house i IT zaufanie do AI w procesie tworzenia oprogramowania rośnie szybciej niż praktyki walidacji linków, pakietów i endpointów.
Czym różni się phantom squatting od typosquattingu i slopsquattingu
Typosquatting wykorzystuje literówki, podobne znaki albo domeny łudząco podobne do znanej marki. Użytkownik sam popełnia błąd albo klika adres, który przypomina prawdziwą stronę.
Slopsquatting jest podobnym wzorcem, ale dotyczy pakietów programistycznych. Model AI może zaproponować nazwę biblioteki, która nie istnieje. Atakujący rejestruje taki pakiet w publicznym repozytorium i czeka, aż ktoś zainstaluje go na podstawie wygenerowanego kodu albo instrukcji.
Phantom squatting przenosi ten sam problem na domeny internetowe. Zamiast fałszywego pakietu mamy fałszywy adres strony, portalu, API albo dokumentacji. To ważne, bo domena jest zrozumiała nie tylko dla deweloperów. Może dotknąć pracowników biura obsługi, księgowości, HR, sprzedaży, administracji, logistyki i zarządu.
Wspólnym mianownikiem jest nie literówka, lecz zaufanie do wygenerowanej odpowiedzi. Atakujący nie musi przewidywać, gdzie użytkownik się pomyli. Może sprawdzić, co model powtarzalnie wymyśla, i zająć tę przestrzeń wcześniej.
Polski kontekst: jak taki scenariusz może wyglądać u nas
W Polsce naturalnymi motywami dla podobnego scenariusza byłyby bankowość, przesyłki, płatności, BLIK, e-commerce, portale HR, systemy księgowe, e-Doręczenia, usługi publiczne i aplikacje SaaS używane w firmach. Nie chodzi o to, że każda z tych marek już jest celem phantom squattingu. Chodzi o to, że nazwy usług, paneli i aplikacji często mają przewidywalną strukturę.
Pracownik może zapytać AI: gdzie zalogować się do panelu przewoźnika, jak pobrać aplikację operatora, gdzie znaleźć formularz dla kontrahenta, gdzie jest dokumentacja API, jak zaktualizować dane płatności, jak połączyć system magazynowy z usługą dostawcy. Jeżeli odpowiedź zawiera link, użytkownik może potraktować go jak skrót do właściwego miejsca.
W realnym procesie firmowym ryzyko rośnie wtedy, gdy link z AI zostaje wklejony do instrukcji, ticketu, dokumentacji w Confluence, opisu procedury, wiadomości w Teams, skryptu automatyzacyjnego albo konfiguracji integracji. Wtedy pierwotna halucynacja przestaje być jednorazową pomyłką. Staje się elementem procesu.
Dlatego same filtry poczty nie wystarczą. Phantom squatting może zacząć się poza skrzynką e-mail. Może wejść przez narzędzie AI, workflow deweloperski, chat firmowy albo automatycznego agenta.
Jak użytkownik powinien traktować link od AI
Link od AI powinien być traktowany jak propozycja, nie jak potwierdzone źródło. To prosta zasada, ale musi zostać przełożona na zachowanie.
Jeżeli AI podaje adres logowania, użytkownik powinien wejść na oficjalną stronę marki z zapisanego źródła, zakładki, dokumentacji firmowej albo wyszukiwarki, a nie bezpośrednio z wygenerowanego linku. Jeżeli chodzi o aplikację mobilną, instalacja powinna pochodzić z oficjalnego sklepu, a nie z pliku pobranego z przypadkowej domeny. Jeżeli chodzi o dokumentację techniczną, adres powinien zostać porównany z domeną producenta albo repozytorium projektu.
Dobre pytanie kontrolne brzmi: skąd wiem, że ta domena należy do właściwej organizacji? Jeżeli odpowiedź brzmi „bo AI tak podało”, to nie jest wystarczająca weryfikacja.
W testach i szkoleniach nie należy ćwiczyć wyłącznie rozpoznawania podejrzanego e-maila. Warto ćwiczyć także sytuację, w której użytkownik dostaje wiarygodnie wyglądający link z narzędzia, które na co dzień pomaga mu pracować. Testy phishingowe dla firm mogą uwzględniać takie momenty decyzji: kliknięcie, sprawdzenie domeny, zgłoszenie wątpliwości i zatrzymanie procesu przed podaniem danych.
Co zrobić, jeśli to już się stało
Jeżeli użytkownik kliknął link podany przez AI i tylko obejrzał stronę, powinien zgłosić sytuację do IT lub Security. Zespół może sprawdzić domenę, historię przeglądarki, reputację adresu, logi proxy, DNS i ewentualne pobrania.
Jeżeli użytkownik wpisał login i hasło, trzeba natychmiast zmienić hasło, unieważnić aktywne sesje, sprawdzić logowania i ocenić, czy konieczny jest reset metod wieloskładnikowego uwierzytelniania. W przypadku kont Microsoft 365, Google Workspace, paneli SaaS i bankowości firmowej nie wystarczy sama zmiana hasła, jeżeli napastnik mógł przejąć sesję albo dodać własną metodę logowania.
Jeżeli użytkownik pobrał plik lub aplikację, urządzenie powinno zostać odłączone od sieci zgodnie z procedurą firmy i przekazane do analizy. Nie warto samodzielnie kasować plików, czyścić historii ani restartować wszystkiego bez konsultacji, bo można utrudnić analizę.
Jeżeli domena wygląda na phishingową, można ją zgłosić wewnętrznie oraz przez formularz CERT Polska. Dla organizacji ważne jest także zebranie kontekstu: skąd pojawił się link, jaki prompt go wywołał, czy odpowiedź AI trafiła do dokumentacji, czy link został rozesłany dalej i czy agent AI mógł wykonać kolejne kroki automatycznie.
Co powinny zrobić IT, Security i SOC
Zespoły bezpieczeństwa powinny dopisać linki generowane przez AI do modelu ryzyka. To nie musi oznaczać blokady wszystkich narzędzi AI. Oznacza konieczność zasad, logowania i punktów kontrolnych.
Pierwszy obszar to walidacja domen. Organizacja powinna mieć jasne reguły dla oficjalnych domen dostawców, portali, dokumentacji, repozytoriów i aplikacji. W praktyce pomaga lista zatwierdzonych źródeł oraz proces zgłaszania nowych domen przed użyciem w procedurze albo automatyzacji.
Drugi obszar to agenci AI. Jeżeli agent może sam otwierać linki, pobierać zasoby albo przetwarzać odpowiedzi stron, powinien działać w ograniczonym środowisku. Dostęp do sieci, tokenów, sekretów, repozytoriów i systemów produkcyjnych musi być ograniczony do realnej potrzeby. Link wygenerowany przez model nie powinien automatycznie oznaczać zgody na pobranie treści.
Trzeci obszar to monitoring. Warto analizować świeżo rejestrowane domeny podobne do marki, domen dostawców i krytycznych usług. W przypadku większych organizacji ma sens obserwowanie certyfikatów, DNS, nowych rejestracji, podobnych nazw i domen używających słów typowych dla portali firmowych, takich jak login, admin, billing, support, help, app, api albo portal.
Czwarty obszar to procedury po incydencie. Jeżeli źródłem podejrzanego linku była odpowiedź AI, zespół powinien umieć odtworzyć prompt, odpowiedź, użytkownika, narzędzie, czas i dalszy przepływ informacji. To pomaga odróżnić jednorazową pomyłkę od błędu, który trafił do dokumentacji albo automatyzacji.
Jak uwzględnić ten temat w security awareness
Phantom squatting jest dobrym tematem do programu awareness, bo dotyka codziennego nawyku: użytkownik ufa narzędziu, które zwykle pomaga. Nie trzeba budować technicznej lekcji o architekturze modeli językowych. Trzeba przećwiczyć kilka konkretnych decyzji.
Pracownik powinien rozumieć, że AI może podać link, który wygląda poprawnie, ale nie jest potwierdzony. Deweloper powinien wiedzieć, że dokumentacja, endpoint i pakiet z odpowiedzi AI wymagają sprawdzenia w oficjalnym repozytorium. Menedżer powinien rozumieć, że wdrożenie AI bez zasad korzystania z linków i danych wejściowych tworzy nowy kanał ryzyka.
W programie security awareness taki temat można połączyć z krótką mikrolekcją, symulacją zgłoszenia i ćwiczeniem „zatrzymaj proces”. Scenariusz nie musi kończyć się kradzieżą hasła. Warto mierzyć też to, czy użytkownik umie rozpoznać niepewne źródło, sprawdzić domenę i zgłosić link przed użyciem.
Dla organizacji, które wdrażają AI w procesach biznesowych albo deweloperskich, dobrym krokiem jest połączenie awareness z kontrolami technicznymi. Szkolenie mówi, kiedy się zatrzymać. Kontrola techniczna ogranicza skutki, gdy człowiek albo agent tego nie zrobi.
Jak przełożyć to na testy phishingowe
Scenariusz testowy może zaczynać się od wiadomości, w której pracownik dostaje „pomocny” link z odpowiedzi AI. Może też dotyczyć dokumentacji wewnętrznej, ticketu od helpdesku, instrukcji aktualizacji danych, portalu dostawcy albo aplikacji mobilnej. Kluczowe nie jest tylko kliknięcie. Ważniejsze są kolejne kroki: sprawdzenie domeny, porównanie z oficjalnym źródłem, zgłoszenie i odmowa wpisania danych.
Dla zespołów technicznych warto przygotować osobny wariant: asystent kodowania podaje dokumentację lub endpoint, a użytkownik musi sprawdzić domenę przed wklejeniem adresu do konfiguracji. To nie jest klasyczna kampania e-mailowa, ale właśnie dlatego dobrze uzupełnia standardowe ćwiczenia.
PHISHLY może pomóc zaprojektować takie scenariusze jako element testów i edukacji, ale nie zastępuje to pełnego zarządzania ryzykiem AI, konfiguracji agentów, monitoringu domen ani procedur bezpieczeństwa. Jeżeli chcesz przećwiczyć ten typ decyzji w swojej organizacji, możesz skontaktować się z PHISHLY i omówić scenariusz dopasowany do procesów pracowników.
Wniosek
Phantom squatting zmienia jedno założenie: link nie musi przyjść od oszusta, żeby prowadzić do miejsca kontrolowanego przez oszusta. Może pojawić się w odpowiedzi narzędzia, które użytkownik lub firma uznaje za pomocne.
Dlatego zasada jest konkretna: domena z AI nie jest źródłem prawdy. Jest tylko tekstem wygenerowanym przez model. Dopiero niezależna weryfikacja decyduje, czy można jej użyć w logowaniu, płatności, kodzie, dokumentacji albo automatycznym procesie.
Najczęstsze pytania
Co to jest phantom squatting?
Phantom squatting to rejestrowanie domen, które wcześniej zostały zmyślone przez model AI, ale wyglądają jak wiarygodne adresy usług, portali lub dokumentacji. Atakujący może później użyć takiej domeny do phishingu, malware albo przechwycenia danych.
Czy link podany przez AI może prowadzić do phishingu?
Tak. Link wygenerowany przez AI nie jest automatycznie zweryfikowanym źródłem. Jeżeli model poda zmyślony adres, a ktoś zarejestruje tę domenę, użytkownik może trafić na fałszywą stronę mimo tego, że link pojawił się w zaufanym narzędziu.
Czym phantom squatting różni się od cybersquattingu?
Cybersquatting zwykle bazuje na podobieństwie do znanej marki, literówce lub wartości domeny. Phantom squatting bazuje na tym, że model AI sam tworzy wiarygodnie brzmiącą, ale nieistniejącą domenę, którą można zarejestrować przed ofiarą albo obrońcą.
Co powinna zrobić firma korzystająca z asystentów AI?
Firma powinna traktować linki z AI jako niezweryfikowane propozycje, ograniczać automatyczne otwieranie adresów przez agentów AI, sprawdzać domeny w oficjalnych źródłach i uczyć pracowników, że odpowiedź AI nie zastępuje weryfikacji.
Źródła
- Unit 42: Phantom Squatting: AI-Hallucinated Domains as a Software Supply Chain Vector — Źródło pierwotne opisujące phantom squatting, skalę badania, cykl ataku, przykłady rejestracji domen i ryzyko dla agentów AI.
- The Hacker News: Phantom Squatting Uses AI-Hallucinated Domains for Phishing and Malware — Źródło wtórne i punkt wejścia do tematu; wykorzystane do weryfikacji kontekstu publikacji i streszczenia raportu Unit 42.
- OpenAI: Dlaczego modele językowe halucynują? — Kontekst wyjaśniający, czym są halucynacje modeli językowych i dlaczego model może generować wiarygodnie brzmiące, ale fałszywe odpowiedzi.
- Socket: The Rise of Slopsquatting — Kontekst porównawczy dla slopsquattingu, czyli podobnego wzorca nadużycia halucynowanych nazw pakietów.
- USENIX Security 2025: We Have a Package for You! — Badanie akademickie dotyczące halucynowanych pakietów w kodzie generowanym przez modele językowe.
- CERT Polska: Zgłoś incydent — Polski kontekst zgłaszania podejrzanych domen, phishingu i incydentów do CSIRT NASK.
Jak działa ta technika?
Wyjaśniamy krok po kroku, jak działa atak i jak go zatrzymać: Phishing – co to jest? Definicja, przykłady i jak się chronić.